
分组交换(Packet Switching)是现代IP网络的基础工作方式之一。与传统电路交换在通信期间为一次连接保留相应资源不同,分组网络把业务数据组织成一个个可以独立处理的数据单元,让语音、视频、网页、文件以及其他业务共同使用网络链路。
数据进入网络以后,并不是一次性从源端直接到达目的端。它通常要经过路由器或其他分组转发节点,每个节点读取必要的地址和控制信息,再决定下一步应该从哪个接口发送出去。
这种方式使网络能够根据实际业务量动态共享带宽,但也带来了排队时延、抖动、丢包和乱序等问题。因此,理解分组交换不能只记住“把长报文切成小包”,还需要理解数据包结构、逐跳转发和统计复用之间的关系。
数据进入分组网络后经历哪些处理
应用程序产生的数据最终要按照通信协议的要求组织成适合网络传输的数据单元。不同协议层使用的名称并不完全一样,例如TCP常把自己的数据单元称为Segment,IP层形成IP数据报或数据包,以太网链路上又会进一步封装成Frame。
从分组交换角度,可以先把它们统一理解成:
用户数据 + 协议控制信息 → 可在网络中独立转发的数据单元
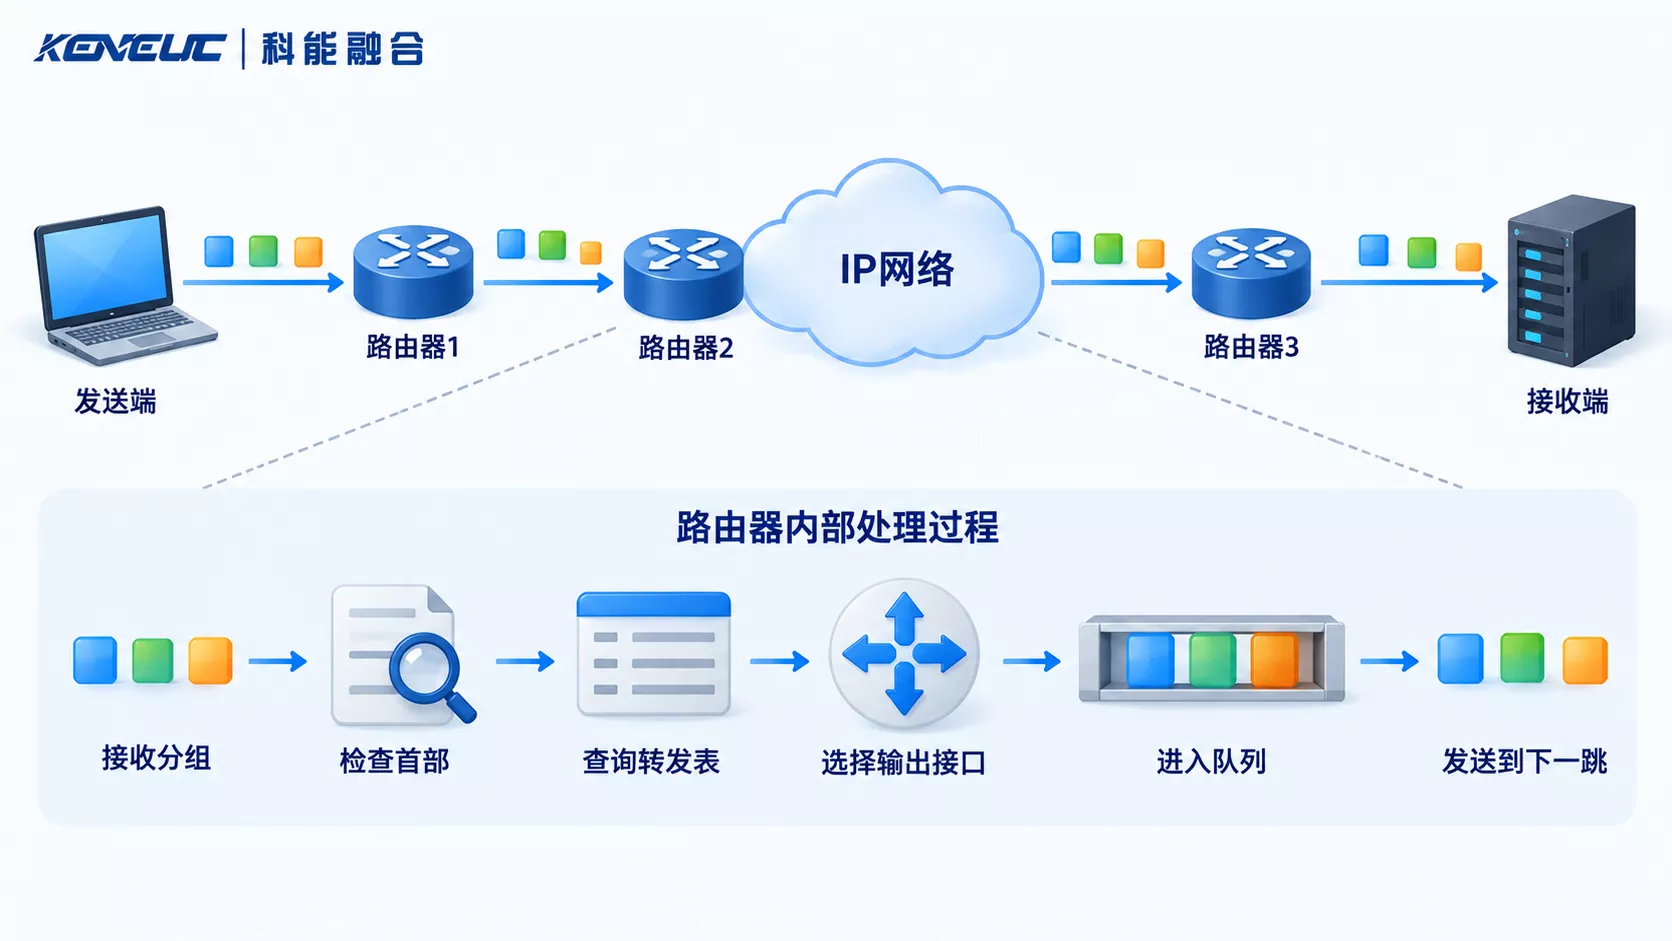
数据包到达一个路由节点以后,通常会经历几个基本步骤:
接收分组 → 检查首部 → 查询转发表 → 选择输出接口 → 进入队列 → 发送到下一跳
随后下一个网络节点重复类似过程,直到数据最终到达目标网络和接收终端。
因此,分组交换并不要求源端提前知道途中每一台设备的详细连接方式。中间节点只需要根据当前网络状态和转发信息,把分组送往下一跳。
一个数据包为什么需要首部和载荷
分组不能只携带用户实际内容,否则中间网络设备不知道它从哪里来、应该送到哪里,也无法判断应该按照什么协议继续处理。
因此一个网络数据包通常可以从两个部分理解:
首部(Header)保存网络控制信息,例如源地址、目的地址、协议类型、长度以及其他与当前协议有关的字段。
载荷(Payload)保存本层真正需要传输的上层数据。
不同协议的首部结构不同。例如IP负责网络层寻址和转发,UDP或TCP又会在自己的首部中加入端口等传输层信息。
所以在VoIP中,一段语音可能形成这样的封装关系:
语音数据 → RTP → UDP → IP → 数据链路帧
每增加一层协议,就会产生一定协议开销,但这种开销并不是原文所说固定的“5%~10%”。实际占比与数据包大小、协议类型、扩展头以及链路封装方式有关。
分组长度也不是统一固定值。现代IP网络中不同数据包可以有不同长度,具体还会受到链路MTU以及应用发送方式等因素影响。
存储转发怎样让分组逐跳通过网络
传统分组交换通常采用存储转发思想。网络节点接收到分组后,根据分组中的目的地址以及自己的转发信息决定下一跳。
例如:
终端A → 路由器1 → 路由器2 → 路由器3 → 服务器B
路由器1只需要判断下一步应该把分组发送给路由器2;路由器2再根据自己的转发表继续判断。整个过程依靠多个节点逐跳完成。
原文把分组交换描述成“一个节点收到整个长报文以后再转发”,容易和报文交换混淆。分组交换的一个重要变化,就是不需要等待完整的大报文全部通过网络节点以后才继续传送。
前面的分组已经进入下一条链路时,后续分组仍可以继续进入前一个节点,从而形成流水线式传输。
不过“存储转发”也不意味着每一个节点都会负责可靠重传。
以IP网络为例,IP本身主要提供尽力而为的数据报转发。数据包在网络中出现丢失时,是否重传以及怎样恢复,要看上层使用什么协议。
例如TCP可以通过确认和重传机制保证可靠数据传输,而实时VoIP常使用UDP/RTP,并不会因为每个语音包丢失都等待重新传输。
统计复用为什么能提高链路利用率
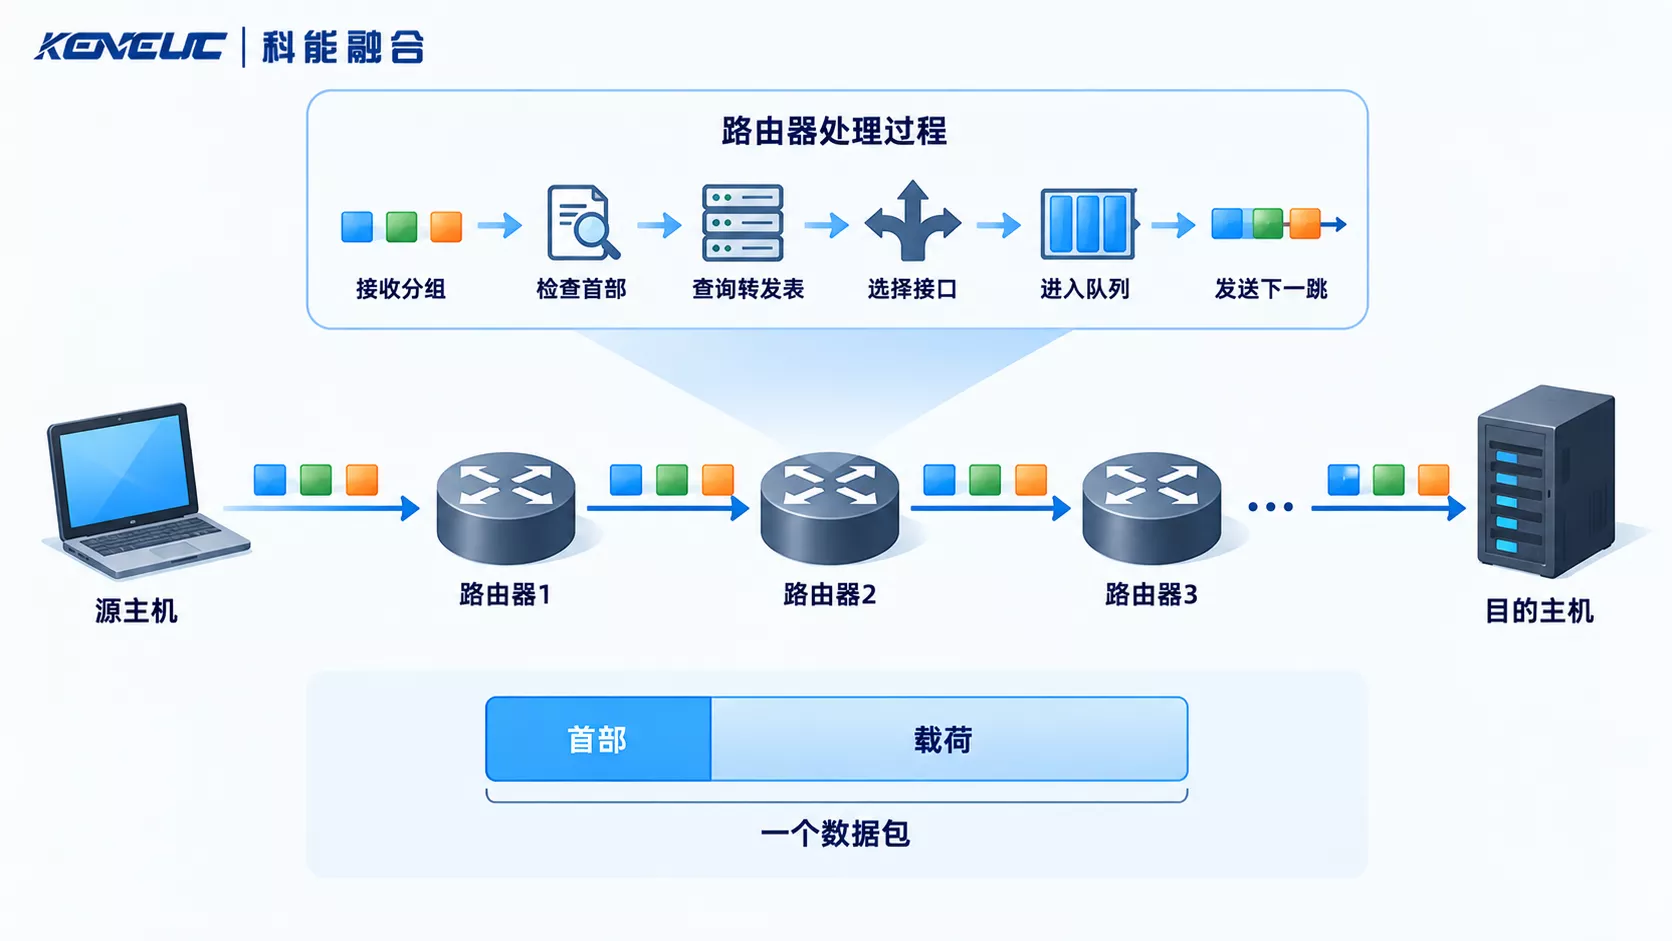
分组网络的一个核心特点,是多个用户和多个业务可以动态共享同一条通信链路。
假设一条链路同时承载网页、电话、视频和文件业务。每个业务都不是始终以最大速率连续发送数据,因此没有必要提前为每一个用户永久划分固定带宽。
有数据需要发送时,相应业务把数据包送入网络;没有数据时,链路资源就可以被其他业务使用。
这种机制通常称为统计复用(Statistical Multiplexing)。
例如一条100Mbit/s链路可以在某个时刻主要承载文件下载,几毫秒以后又同时出现语音、视频和网页数据。网络设备按照当前队列和调度策略连续发送不同业务的数据包。
这种共享方式与传统固定TDM时隙不同。TDM中的某个时隙即使暂时没有有效业务,也仍然属于预先分配的通道;统计复用则根据实际业务到达情况动态使用链路。
排队为什么会产生时延、丢包和乱序
共享链路提高了资源利用率,也意味着多个数据包可能同时需要从同一个出口发送。
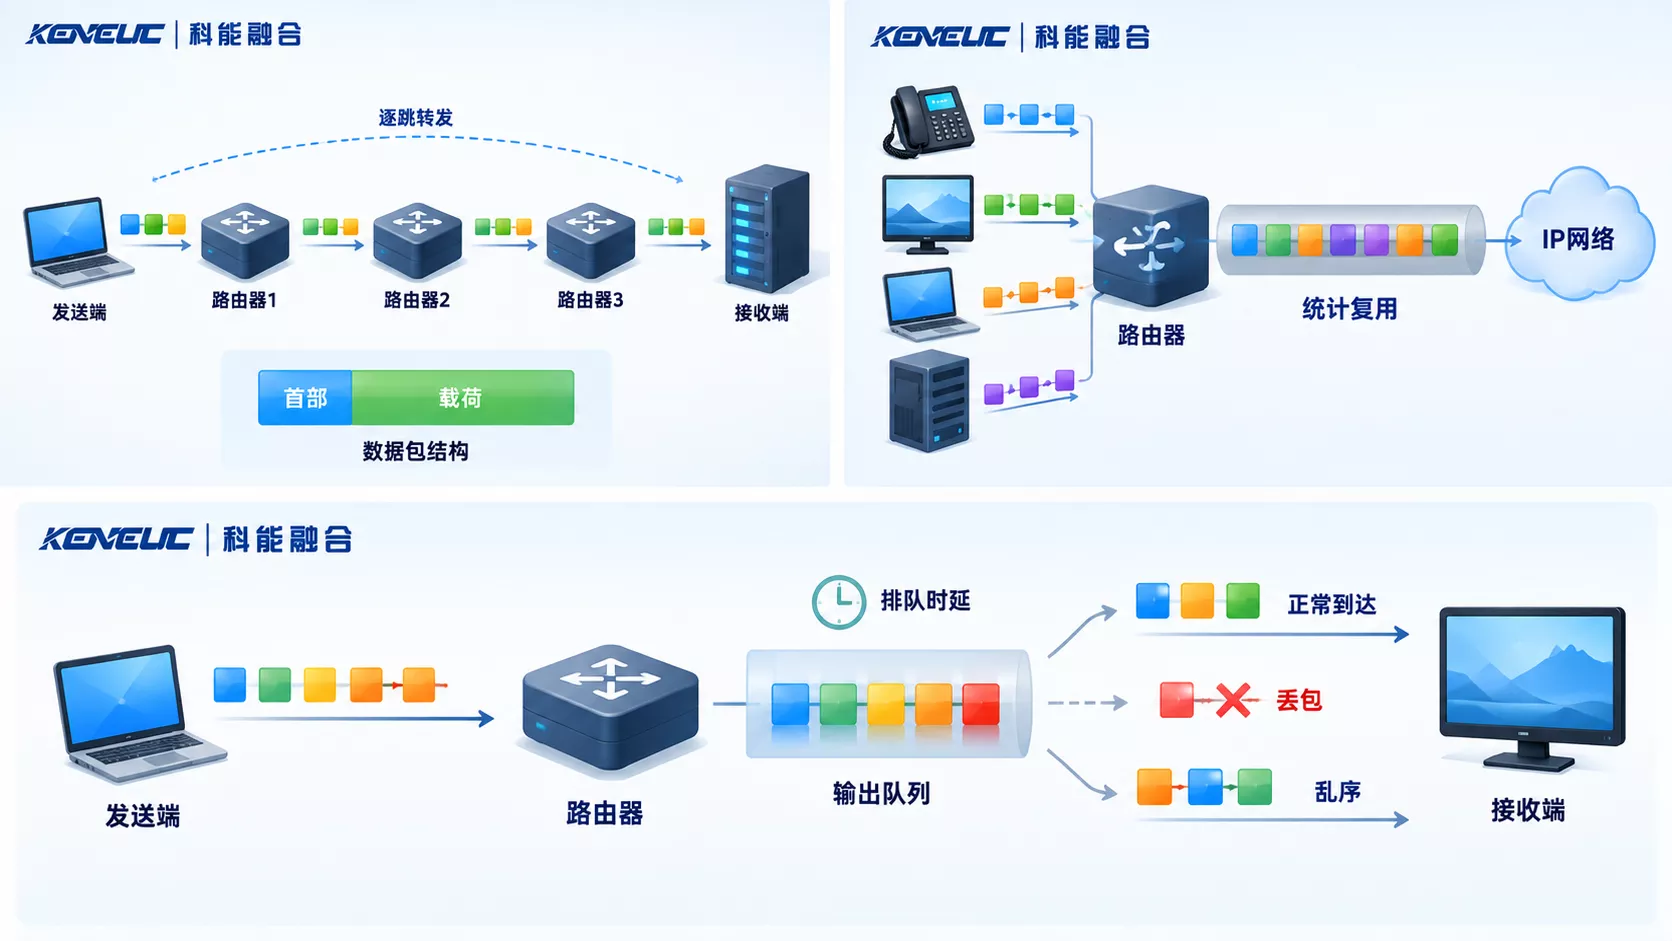
如果出口链路当前正在发送其他数据,新到达的分组就要先进入缓存队列。这段等待时间就是排队时延。
网络负载较低时,排队可能很短;流量突然增加时,队列会逐渐变长,端到端时延也会随之增加。
如果数据到达速度长期高于出口能够发送的速度,缓存最终可能被占满,新到达的数据包就可能被丢弃。
所以分组网络中经常会看到几个关键现象:
- 时延:分组从发送端到接收端需要时间;
- 抖动:不同分组经历的时延并不完全一致;
- 丢包:网络拥塞或链路异常导致部分分组无法到达;
- 乱序:数据报经过不同路径或不同队列以后,可能改变到达顺序。
原文把“分组较短,所以出错概率必然减少”作为分组交换优势并不严谨。实际可靠性取决于链路质量、协议校验、网络拥塞和上层恢复机制,而不是单纯由数据包长度决定。
对于普通文件传输,TCP可以重新发送丢失的数据;对于实时语音,一个包如果重新传输以后已经错过播放时间,重传价值往往很低。
数据报和虚电路都属于分组交换
分组交换并不等于“所有网络都没有连接”。这是理解分组网络时经常出现的误区。
分组交换可以采用不同工作模式。
数据报方式中,每个分组可以根据自身携带的目的地址独立转发。IP就是最典型的数据报网络。
虚电路方式则在发送数据以前先建立一条逻辑连接,后续分组按照已经建立的虚电路关系转发。X.25、Frame Relay等历史网络中可以看到这种方式。
虚电路虽然使用“电路”这个名称,但它仍然不是传统电路交换中长期独占资源的实体话路,多条逻辑连接仍然可以共享实际传输链路。
这部分站内PSDN分组交换数据网已经详细介绍,因此本页只保留这一基本区别,不再重复展开具体网络技术。
分组交换为什么最终能够承载VoIP
早期分组网络主要面向计算机数据,因为实时语音对时延、抖动和连续性要求较高,而当时的网络带宽、路由设备和语音编码能力有限。
随着IP网络速度、QoS机制和实时媒体技术发展,语音也可以通过分组网络稳定传输。
在VoIP中,语音经过Codec编码以后,被组织成RTP媒体数据,再通过UDP/IP网络发送。
典型链路可以表示为:
语音 → Codec → RTP → UDP/IP → 分组网络 → RTP → Codec → 语音
这意味着电话不再必须长期占用传统PSTN中的固定64kbit/s TDM时隙,而可以与网页、视频和其他数据一起共享IP网络。
但实时语音并没有因此失去对网络质量的要求。VoIP仍需要通过QoS、抖动缓冲、丢包处理和合理的媒体编码控制实际通话质量。
关于传统电话为什么使用电路交换,以及VoIP为什么能够转向分组承载,可以参考电路交换与分组交换有什么区别;如果需要进一步了解RTP、RTCP和Codec的实际媒体路径,则可以继续查看VoIP中的媒体是什么。
分组交换真正改变的不是“把一份文件切得更小”,而是网络资源的使用方式。多个业务可以通过统计复用共享链路,中间节点依据地址逐跳转发数据,同时通过队列和调度处理瞬时流量。这套机制最终成为今天Internet、企业IP网络以及VoIP通信的共同基础。